


אם אני צריך לענות על זה במשפט אחד: מודל ייחוס לא משנה מי מכר בפועל – הוא משנה איך אני מחלק את הקרדיט בין Google, Meta, TikTok, אימייל ושאר הערוצים.
אם אני מריץ קמפיינים בכמה פלטפורמות, יש לי 3 בדיקות לפני כל החלטת תקציב:
- איזו שאלה אני מנסה לענות עליה – מי יצר ביקוש, מי תמך בדרך, או מי סגר המרה
- איזה מודל מתאים לשאלה – ראשון, אחרון, ליניארי, מבוסס מיקום, דעיכת זמן, או DDA
- האם המדידה בכלל מסודרת – UTM, חלון ייחוס, הגדרת המרה, ותיאום בין Google Ads, GA4 ויתר הכלים
יש כאן גם כלל פשוט:
אם אין מספיק המרות, עדיף מודל פשוט.
ברוב המקרים, DDA דורש בערך 300–500 המרות על פני 30–90 יום כדי לתת תמונה שאפשר לעבוד איתה.
עוד נקודה שאני לא מפספס:
פער של 10%–20% בין Google Ads ל-GA4 הוא לרוב רגיל. זה קורה בגלל חלונות ייחוס שונים, תאריך קליק מול תאריך המרה, ושיטות ספירה שונות. אם הפער גדול מזה, אני קודם בודק מעקב והגדרות – לא מחליף מודל ישר.
סקירה מהירה של המודלים:
- First-click – טוב כשאני רוצה לבדוק מי הכניס קהל חדש
- Last-click – טוב כשאני בודק מי סגר
- Linear – טוב כשאני רוצה חלוקה שווה לאורך הדרך
- Position-based – טוב כשגם ההתחלה וגם הסוף חשובים לי
- Time decay – טוב כשיש מסלול קצר והשלבים האחרונים מקבלים יותר משקל
- DDA – טוב כשיש הרבה נתונים ורוצים חלוקה לפי דפוסים בנתונים
השורה התחתונה:
לפני שאני מחליף מודל, אני מוודא שהנתונים נקיים, מריץ ישן וחדש במקביל, ורק אחר כך משנה החלטות תקציב בש"ח.
איך מודלים של ייחוס מחלקים קרדיט לאורך מסלול ההמרה
מודל ייחוס מחלק את הקרדיט בין נקודות המגע לאורך מסלול ההמרה. בפועל, יש שני סוגים עיקריים: מודלים מבוססי כללים וייחוס מבוסס נתונים.
מודלים מבוססי כללים: ראשון, אחרון, ליניארי, מיקום, ודעיכת זמן
כאן הקרדיט נקבע מראש לפי כלל קבוע. אותו מסלול יכול להיראות אחרת לגמרי, תלוי במודל שבוחרים.
| מודל | איך הוא מחלק קרדיט | מתאים במיוחד ל… |
|---|---|---|
| First-click (קליק ראשון) | 100% לנקודת המגע הראשונה | ניתוח ערוצי גילוי ומודעות |
| Last-click (קליק אחרון) | 100% לנקודת המגע האחרונה לפני ההמרה | דיווח מהיר על ערוצי סגירה |
| Linear (ליניארי) | חלוקה שווה בין כל נקודות המגע | מבט מאוזן על מסלולים קצרים יחסית |
| Position-based (מיקום) | 40% לראשון, 40% לאחרון, 20% לנקודות האמצע | קמפיינים שמשלבים רכישה וסגירה |
| Time decay (דעיכת זמן) | יותר קרדיט לנקודות קרובות יותר להמרה | מוצרים עם מחזור החלטה קצר |
היופי במודלים האלה הוא הפשטות. קל להבין אותם, קל להסביר אותם, וקל להפעיל לפיהם דוחות. מצד שני, הם לא תמיד משקפים את מה שקרה בפועל. אם המסלול של הלקוח לא יושב טוב על כלל קבוע, התמונה עלולה להיות חלקית.
בדיוק בנקודה הזאת נכנס ייחוס מבוסס נתונים.
ייחוס מבוסס נתונים: קרדיט לפי תרומה בפועל
במקום להחליט מראש מי יקבל כמה, המודל בודק נתוני עבר ממסלולי המרה ומחשב את התרומה היחסית של כל נקודת מגע.
ייחוס מבוסס נתונים (Data-Driven Attribution – DDA) מנתח נתוני עבר ממסלולי המרה – גם של משתמשים שהמירו וגם של כאלה שלא – ומעריך את התרומה היחסית של כל נקודת מגע.
זה כבר לא "הקליק הראשון תמיד מקבל הכול" או "הקליק האחרון סוגר עניין". הרעיון הוא לבדוק מה קרה בפועל במסלולים קודמים, ואז לחלק קרדיט לפי הדפוסים שעולים מהנתונים.
אבל יש פה קאץ': חשבונות עם מעט המרות לא תמיד מספקים מספיק נתונים למידול שאפשר לסמוך עליו. לעומת זאת, עסקים שמריצים קמפיינים רחבי היקף בכמה פלטפורמות – Google, Meta, TikTok ועוד – יכולים להפיק מ-DDA תמונה מדויקת יותר לצורך קבלת החלטות תקציביות בש"ח. לכן, הוא מתאים במיוחד לקמפיינים רב-ערוציים עם נפח המרות גבוה.
sbb-itb-1ec8384
איך בוחרים את מודל הייחוס הנכון למטרת הדיווח שלכם
אחרי שמבינים איך כל מודל מחלק קרדיט, הבחירה נעשית לפי השאלה העסקית שאתם מנסים לענות עליה: חשיפה, תרומה לאורך המסלול, או סגירה.
במילים פשוטות, לא שואלים איזה מודל "הכי נכון" באופן כללי. שואלים איזה מודל מתאים לדוח הספציפי שאתם בונים.
התאמת המודל למטרה: מודעות, שיקול, או המרה
| מטרת הדוח | מודל מומלץ |
|---|---|
| חשיפה – איזה ערוץ הכניס קהל חדש | First-click |
| תרומה לאורך המסלול – איך הערוצים תרמו ביחד | Linear / Position-based |
| סגירה – מה המיר בפועל | Last-click / DDA / Time-decay |
שימוש באותו מודל לכל מטרה פשוט מעקם את התמונה.
אם אתם בודקים כניסת קהל חדש, הגיוני לתת משקל לנקודת המגע הראשונה. אם אתם מנסים להבין איך כמה ערוצים עבדו יחד, צריך מודל שמחלק קרדיט לאורך הדרך. ואם המטרה היא לבדוק מה סגר את ההמרה בפועל, נכון יותר להסתכל על המגע האחרון או על מודל שנותן יותר משקל לשלבים המאוחרים.
כשכללים קבועים כבר לא נותנים תשובה טובה, עוברים לשאלה הבאה: האם יש בכלל מספיק נתונים כדי לעבוד עם מודל מבוסס-נתונים.
מתי לבחור מודל פשוט ומתי DDA
מודלים מבוססי כללים מתאימים כשצריך פשטות, כשנפח ההמרות נמוך, או כשאין מספיק נתונים ל-DDA.
DDA מתאים כשיש נפח המרות עקבי מספיק. בלי נפח כזה, מודל פשוט יותר יהיה יציב יותר.
זה קצת כמו לנסות להסיק מסקנות ממשחק אחד במקום מעונה שלמה. אם אין מספיק המרות, מודל מתקדם עלול לייצר יותר רעש מאשר תשובה ברורה.
שאלות לשאול לפני שמחליפים מודל
לפני שמחליפים מודל ייחוס, כדאי לעצור רגע ולבדוק שלושה דברים:
- האם הבעיה היא במודל או במעקב? אם הנתונים לא עקביים בין פלטפורמות, סביר יותר שמדובר בבעיית תיוג UTM, מעקב בין-דומייני, או הגדרת המרה – ולא בבחירת המודל.
- האם ההמרות מוגדרות באופן זהה בכל הכלים? הגדרה שונה של "ליד" בין Google Ads, GA4 ו-Meta יכולה לגרום לכך שהחלפת מודל תיראה כמו שינוי בביצועים, למרות שבפועל זה רק שינוי בהגדרה.
- האם יש מספיק נתונים כדי שמודל מתקדם יותר ייתן תוצאות שאפשר לסמוך עליהן? בלי נפח המרות מספק, מעבר ל-DDA עלול להוסיף רעש במקום בהירות.
במעבר בין מודלים, כדאי להריץ את הישן ואת החדש במקביל, ואז להשוות תוצאות לפני שמקבלים החלטה.
הבדלים בין פלטפורמות, הגדרות נתונים, ועקביות בדיווח
אחרי שבוחרים מודל ייחוס, צריך ליישר את ההגדרות בין המערכות. בלי זה, אותה המרה יכולה להיראות אחרת ב-Google Ads, ב-GA4 וב-Search Ads 360. גם מודל ייחוס טוב לא יעזור אם כל מערכת "מבינה" את הנתונים קצת אחרת.
Google Ads, GA4, ו-Search Ads 360: ההבדלים המרכזיים
| פלטפורמה | היכן הייחוס מוגדר | מה הוא משפיע | נקודה חשובה |
|---|---|---|---|
| Google Ads | ברמת פעולת ההמרה | דיווח המרות, ערך המרה, Smart Bidding | הייחוס משפיע על דיווחי המרות ועל Smart Bidding. |
| GA4 | ברמת הנכס (Property) | דוחות ערוצים, ניתוח מסלולים, השוואת מודלים | GA4 מייחס בין ערוצים שונים, וברירת המחדל שלו היא data-driven. |
| Search Ads 360 | ברמת Floodlight והגדרות הייחוס | ביצועי חיפוש רב-מנועי, אופטימיזציית bidding | שינוי בהגדרת הייחוס משפיע גם על הדיווח וגם על הבידינג. |
ההבדל המעשי הכי חשוב הוא זה: Google Ads מייחס המרות לפי אינטראקציות ומודעות בתוך Google Ads, בזמן ש-GA4 מפעיל ייחוס חוצה-ערוצים ומחלק קרדיט בין כל מקורות התנועה – אורגני, אימייל, סושיאל, ישיר ותשלום. לכן, אותה המרה לא תמיד תופיע אותו דבר בכל מערכת. הכול תלוי במודל הייחוס ובחלון שנבחר.
יש גם הבדל נוסף שקל לפספס. Google Ads מדווח על המרות לפי תאריך הקליק שהוביל להמרה, ואילו GA4 מדווח לפי תאריך ההמרה בפועל. בפועל, זה אומר שגם אם סך ההמרות דומה, הפיזור היומי יכול להיראות שונה לגמרי.
מה חייב להיות מוגדר לפני שסומכים על הדוחות
לפני שמתחילים לנתח ביצועים, כדאי לוודא שהבסיס מסודר. אלה הדברים שצריכים להיות מיושרים:
- תקינות תגים – לוודא שכל אירועי ההמרה נרשמים כמו שצריך ובצורה עקבית בכל הפלטפורמות.
- הגדרת המרה אחידה – להחליט מה נחשב ל"ליד" או ל"רכישה", ולתעד את זה ברור. זה כולל גם הבחנה בין פעולה מלאה לפעולה חלקית.
- מיפוי אחיד בין מערכות – להכין טבלה פשוטה שמחברת בין lead, demo, purchase וכל יעד עסקי אחר, בכל אחד מהכלים.
- חלון ייחוס מתואם – למשל, 30 יום לקליק בקמפיינים של B2C, או 60–90 יום בקמפיינים של B2B עם מחזור מכירה ארוך יותר.
- UTM עקבי – להשתמש ב-
utm_source,utm_mediumו-utm_campaignעם מבנה שמות אחיד ובאותיות קטנות. - נפח נתונים מספק – מודל data-driven דורש בדרך כלל לפחות 300–500 המרות על פני 30–90 יום כדי לעבוד בצורה שאפשר לסמוך עליה.
אם אחד מהחלקים האלה לא מסודר, הדוחות עלולים להטעות. לא בגלל שהפלטפורמה "טועה", אלא כי כל כלי עובד לפי הגדרות אחרות.
למה הדוחות לא מסתדרים בין פלטפורמות
פער של 10%–20% בין Google Ads ל-GA4 נחשב בדרך כלל תקין. זה אולי נשמע מתסכל, אבל זה לא חריג. פערים גדולים יותר מגיעים לרוב מכמה סיבות די ברורות: חלונות ייחוס שונים בין הפלטפורמות, שיטת ספירה אחרת, הגבלות פרטיות ו-Consent Mode, או תיוג UTM לא עקבי שמפצל תנועה לערוצים שונים ב-GA4.
דוגמה פשוטה: Google Ads יכול לספור כל המרה בנפרד, בזמן ש-GA4 סופר אירועים, לא רק קליקים. תוסיפו לזה חלון lookback אחר או בסיס זמן אחר, וקיבלתם שני דוחות שנראים כאילו הם מספרים שני סיפורים שונים.
כשמשווים בין פלטפורמות, צריך ליישר קודם ארבעה ממדים: אירוע ההמרה, מודל הייחוס, חלון ה-lookback ובסיס הזמן.
תמיכה במדידה רב-פלטפורמית לקמפיינים משולבים
כשמריצים קמפיינים במקביל על Google, Meta, LinkedIn ופלטפורמות נוספות, הנתונים מתפזרים מהר מאוד. ואז מתחילה הבעיה המוכרת: כל מערכת נראית "צודקת", אבל התמונה הכוללת לא ברורה.
במצב כזה, הצעד הבא הוא ליישר תגים, המרות ודשבורדים לפני שמפרשים את התוצאות. אחרת, קל מאוד לקרוא לפער טכני "פער ביצועים" – כשבפועל מדובר פשוט בשתי מערכות שסופרות אחרת.
ברגע שכל שלוש השכבות האלה מיושרות, השוואה בין פלטפורמות הופכת להרבה יותר נקייה, והרעש הטכני כבר לא משתלט על התמונה.
יתרונות ומגבלות של מודלי הייחוס הנפוצים
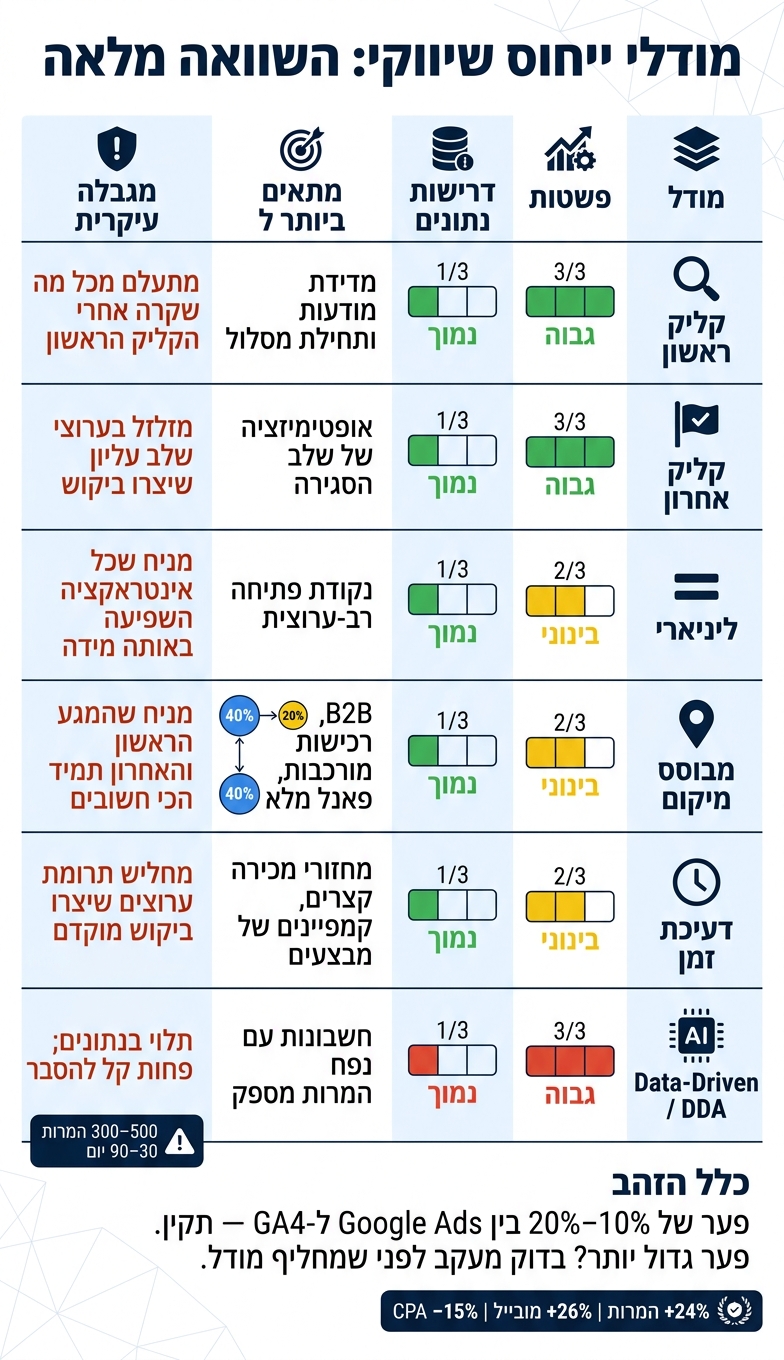
מודלי ייחוס שיווקי: השוואה מלאה לפי מטרה, פשטות ודרישות נתונים
כל מודל ייחוס שם זרקור על חלק אחר במסלול ההמרה. לכן, הבחירה במודל לא נעשית בוואקום – היא תלויה במטרת הדיווח, באופן שבו הצוות מקבל החלטות, וכמובן גם בכמות ואיכות הנתונים שיש לכם. את הפערים בין המודלים אפשר לראות היטב כאן:
| מודל | פשטות | דרישות נתונים | מתאים ביותר ל | מגבלה עיקרית |
|---|---|---|---|---|
| First Click | גבוהה | נמוכות | מדידת מודעות ותחילת מסלול | מתעלם מכל מה שקרה אחרי הקליק הראשון |
| Last Click | גבוהה | נמוכות | אופטימיזציה של שלב הסגירה | מזלזל בערוצי שלב עליון במשפך שיצרו את הביקוש |
| Linear | בינונית | נמוכות | נקודת פתיחה רב-ערוצית | מניח שכל אינטראקציה השפיעה באותה מידה |
| Position-Based | בינונית | נמוכות | B2B, רכישות מורכבות, פאנל מלא | מניח שהמגע הראשון והאחרון תמיד הכי חשובים |
| Time Decay | בינונית | נמוכות | מחזורי מכירה קצרים, קמפיינים של מבצעים | מחליש את תרומת הערוצים שיצרו ביקוש מוקדם |
| Data-Driven | נמוכה | גבוהות | חשבונות עם נפח המרות מספק ותשתית נתונים יציבה | תלוי בנפח נתונים; פחות קל להסבר לצוותים |
מודלים מבוססי כללים קלים להבנה, וזה חלק גדול מהקסם שלהם. אבל יש פה גם מלכוד: הם מציירים תמונה פשוטה מדי. Last Click, למשל, נוטה לתת יותר מדי קרדיט לחיפוש ממותג ולרימרקטינג. בפועל, זה עלול לגרום לערוצי מודעות שיצרו את הביקוש מלכתחילה להיראות חלשים יותר ממה שהם.
במודלים מתקדמים, סוג המודל הוא רק חצי מהסיפור. החצי השני הוא איכות המדידה. Data-Driven attribution עשוי לתת תמונה קרובה יותר למה שקרה בפועל, אבל רק אם יש תשתית מדידה טובה, מעקב נקי ונפח המרות מספיק. בלי זה, גם מודל חכם יישען על בסיס רעוע.
דוגמה טובה לזה מגיעה מחברת הנסיעות הגרמנית Berge & Meer. החברה עברה ל-data-driven attribution ב-Google Ads, ותוך חודשיים ראתה עלייה של 24% בהמרות, שיפור של 26% בשיעור ההמרה ממובייל, וירידה של 15% ב-CPA.
בשורה התחתונה, הבחירה הנכונה מתחילה בהתאמה בין המודל, נפח הנתונים ויעד המדידה. ורגע לפני שסומכים על המספרים, כדאי לבדוק שהגדרות המדידה עקביות בין כל הפלטפורמות. אחרת, גם הדוח הכי יפה עלול להטעות.
סיכום: מה לבדוק לפני שמחליפים מודל ייחוס
אחרי שבחרתם מודל לפי מטרת הדיווח, עצרו רגע ובדקו את המדידה עצמה לפני המעבר. זה החלק שקל לפספס. שינוי מודל ייחוס משנה רק את חלוקת הקרדיט – לא את מה שקרה בפועל.
לפני כל שינוי, שאלו: איזו החלטה הדוח אמור לתמוך בה? האם הוא נועד להקצאת תקציב, להערכת ערוץ, לניתוח של כל המשפך, או לדיווח להנהלה? התשובה הזו קובעת איזה מודל מתאים. בלי מטרה ברורה, קל מאוד לבחור מודל שלא משרת את השימוש בפועל.
אחר כך מגיע שלב ניקוי הנתונים. לפני שמחליפים מודל, בדקו ש-UTM עקביים, שהגדרות ההמרה מיושרות, ושחלון הייחוס אחיד. אם יש פער של יותר מ-10–20% בין ההמרות המדווחות לבין המכירות בפועל, זה בדרך כלל מצביע על בעיית מדידה או הגדרה – לא על בעיה במודל הייחוס.
רק כשההגדרות מסודרות, כדאי לבדוק את השינוי עצמו. הפעילו את המודל הישן והחדש במקביל, בחנו איך הדפוסים משתנים, ורק אז בצעו את המעבר הרשמי. אחרי המעבר, עקבו במשך 2–4 שבועות לפני שמסיקים מסקנות. אם איכות הנתונים, היעדים, או אופן השימוש בדוח עדיין לא ברורים, עדיף לחכות עם השינוי. אחרת, לא תשנו את המציאות – רק את הדרך שבה היא נראית.


